
논문을 발표하기 위해 VLDB 2026에 참석했다. 올해 VLDB는 미국 보스턴에서 개최되었다. VLDB는 데이터베이스와 데이터베이스 분야에서 규모가 큰 학회라, 평소에 접하지 못했던 연구들을 많이 볼 수 있을 것 같아 기대가 되었다.
이번 학회는 개인적으로도 의미가 컸다. 처음으로 학회에 제출한 논문이 accept되어 직접 발표하는 자리였기 때문이다. 발표 자체는 12분 남짓이었지만, 처음 하는 학회 발표이다 보니 출국하기 전부터 발표 자료를 계속 고치고 연습했다. 예상 질문도 생각해보고, 짧은 시간 안에 연구 내용을 얼마나 명확하게 전달할 수 있을지 걱정도 많이 했다.
 학회 첫날에는 ADMS 워크숍을 주로 들었다. 이름 그대로 CPU, GPU, accelerator, memory 및 storage와 같은 새로운 하드웨어를 데이터 시스템에서 어떻게 활용할 것인지를 다루는 워크숍이었다. 평소 시스템 쪽 연구와 비교적 가까운 주제를 다루고 있어서 본 학회 세션보다 조금 더 익숙할 것이라고 생각했는데, 막상 들어보니 그렇지만도 않았다.
특히, NVIDIA의 Joshua Patterson이 발표한 ‘From MapD to Sirius: Co-Designing GPU-Native OLAP’ 키노트가 인상 깊었다. 과거에는 GPU database가 제한된 GPU memory와 PCIe를 통한 데이터 이동 비용 때문에 널리 사용되기 어려웠지만, GPU의 HBM 용량이 커지고 CPU-GPU 및 GPU 간 interconnect가 빨라지면서 상황이 많이 바뀌었다는 내용이었다. Q&A도 재미있었다. GPU에는 Tensor Core처럼 점점 더 많은 특수한 연산 장치가 추가되고 있는데, database workload 입장에서는 모든 하드웨어를 잘 활용하기가 어렵다. 앞으로 이런 특수 하드웨어가 계속 늘어난다면 데이터 시스템에서 과연 이를 얼마나 효과적으로 활용할 수 있을지에 대한 질문이 나왔다. 새로운 하드웨어가 나온다고 해서 기존 소프트웨어가 자동으로 빨라지는 것은 아니고, 결국 workload와 hardware 사이의 interface를 어떻게 설계할 것인지가 여전히 중요한 연구 문제라는 생각이 들었다.
또 하나 재미있었던 것은 ‘HW-SW Co-Design for Databases in the Age of AI-for-Systems’ 패널이었다. 새로운 hardware가 매우 빠른 주기로 등장하는 상황에서 어떤 abstraction이 필요한지, 앞으로 hardware와 software가 각각 어떤 역할을 해야 하는지, 그리고 어느 정도까지 specialization을 감당할 수 있는지를 이야기했다. 특히 AI agent가 코드를 점점 잘 작성하게 된다면 새로운 hardware가 나올 때마다 사람이 범용 abstraction을 만들어야 하는가 하는 이야기가 흥미로웠다. 극단적으로는 agent가 30분 만에 새로운 hardware에 맞게 코드를 최적화해 준다면 abstraction이 덜 중요해질 수도 있다. 반면 시스템 자체가 너무 복잡하기 때문에 문제를 적절하게 나누고 사람이 이해하기 위해서라도 abstraction은 여전히 필요하다는 의견도 있었다.
Hardware specialization에 관한 이야기도 기억에 남는다. 새로운 accelerator를 설계하는 것은 비용이 매우 크고, 특정 database workload에만 사용할 수 있는 hardware라면 활용 범위도 제한된다. 반면 software workload는 빠르게 변하기 때문에 hardware가 완성되었을 때에는 이미 요구사항이 바뀌어 있을 수도 있다. 결국 GEMM처럼 다양한 시스템에서 재사용할 수 있는 primitive 수준의 building block을 찾아내는 것이 중요하다는 의견이었다. 시스템 소프트웨어를 연구하는 입장에서 software와 hardware의 경계를 어디에 두어야 할지는 항상 어려운 문제인데, database 분야에서도 거의 같은 고민을 하고 있다는 점이 인상적이었다.
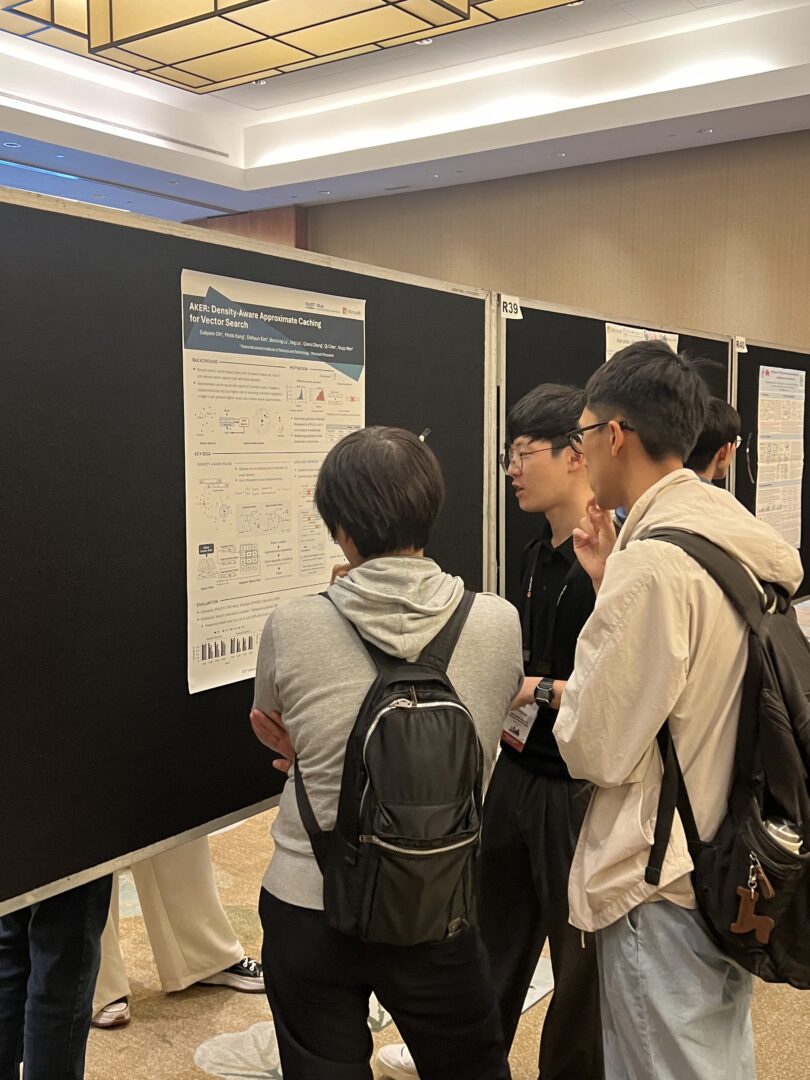
이번 학회에서 발표한 논문은 ‘Aker: Density-Aware Approximate Caching for Vector Search’로, disk-based vector search에서 유사한 과거 query의 결과를 cache해 disk access를 줄이는 연구이다. 발표 자체보다 오히려 기억에 남았던 것은 이후 poster session이었다. 처음에는 발표가 끝나면 크게 관심을 갖는 사람이 없을 수도 있다고 생각했는데, 예상보다 여러 사람들이 포스터를 찾아와 연구 내용을 물어봐 주었다.
 |
 |
종합적으로 VLDB에서 가장 크게 느낀 점은 역시 Database 학회라는 것이었다. 평소 접하던 시스템 논문과 겹치는 부분도 있었지만, query planning, query optimization, query execution, 각종 join algorithm부터 수학적인 증명까지 처음 접하는 주제도 정말 많았다. 처음에는 모르는 용어가 연속으로 나오는 발표를 들으면 조금 당황스러웠는데,
며칠 동안 여러 세션을 돌아다니면서 데이터베이스라는 분야가 생각했던 것보다 훨씬 넓고, 동시에 systems와 architecture를 깊게 다루고 있다는 것을 알 수 있었다.
학회 일정 사이에는 보스턴도 조금 둘러보았다. 보스턴에는 MIT와 Harvard를 비롯해 유명한 학교들이 가까이 모여 있어서 시간을 내어 두 학교를 방문했다.
 |
 |
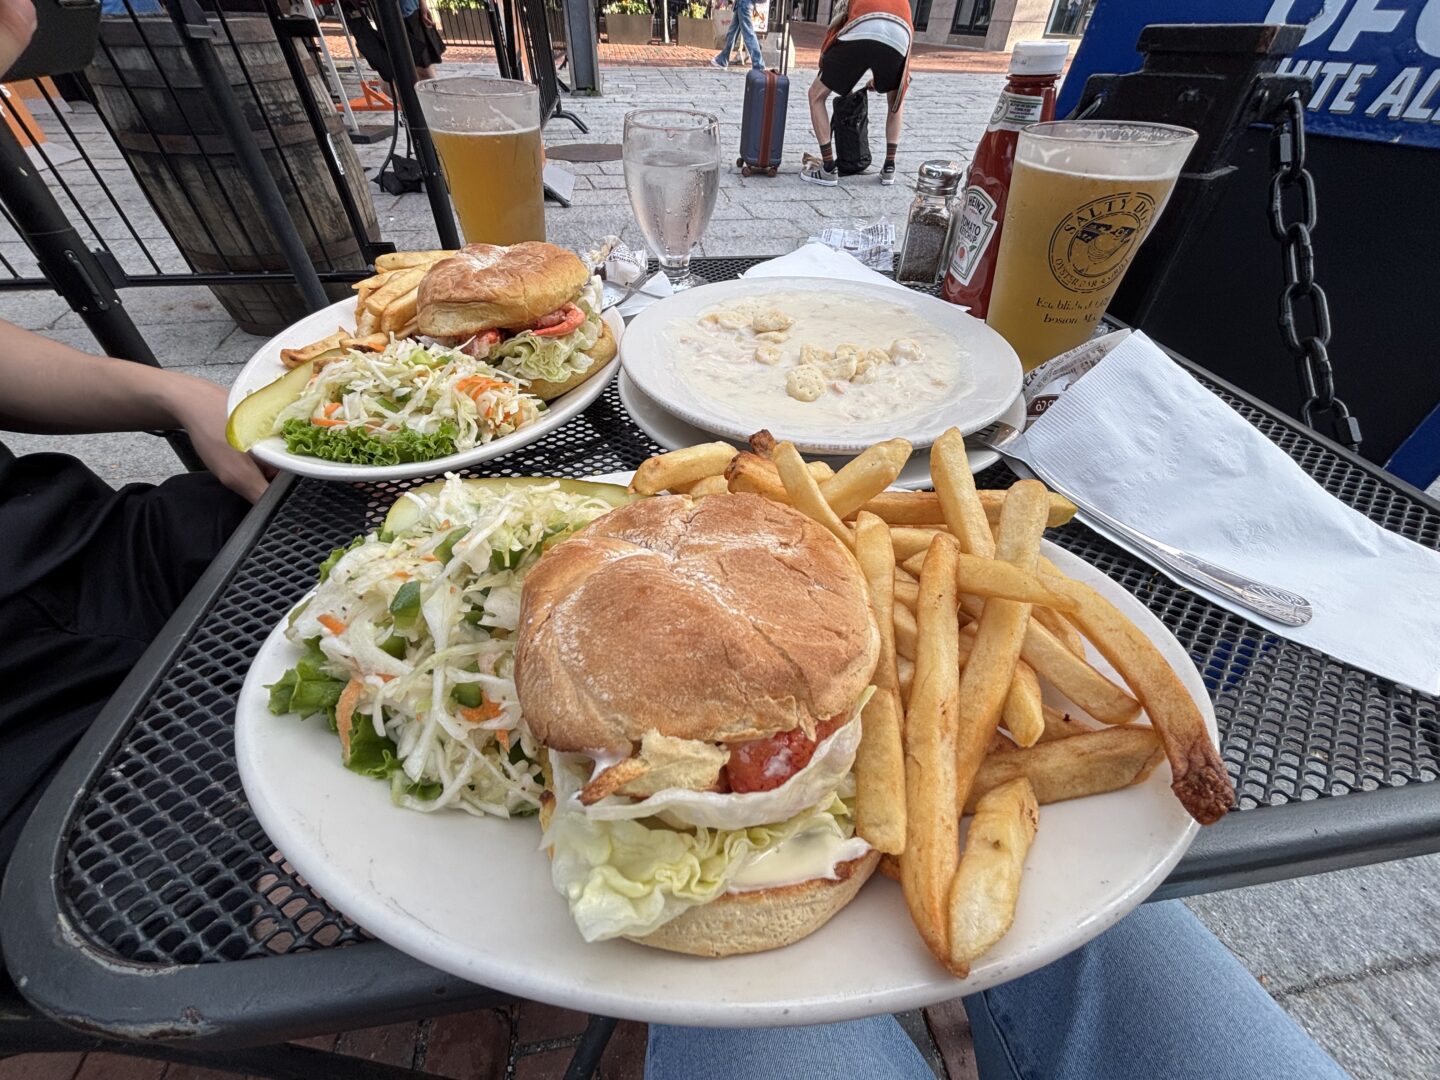
보스턴에 왔으니 유명하다는 lobster sandwich도 먹어보았다. 기대를 너무 많이 해서인지 개인적으로는 생각보다 특별하지는 않았다. 물론 맛이 없는 것은 아니었는데, 다시 보스턴에 와서 꼭 찾아 먹어야 할 정도는 아니었던 것 같다.
 |
 |
도시 자체는 관광지처럼 압도적인 볼거리가 많다는 느낌은 아니었다. 대신 거리가 비교적 깔끔했고, 건물이나 도로, 가게들의 모습에서 전형적으로 상상하던 미국 도시의 분위기가 느껴졌다. MIT와 Harvard 주변을 걸어보고 시내를 돌아다니는 것만으로도 미국에 와 있다는 느낌은 충분히 받을 수 있었다.
학회 기간 중에는 연구실 졸업생인 오준택 박사님과 함께 저녁식사를 할 기회도 있었다. 해외 학회에 와서 연구실 선배를 다시 만나 함께 식사할 수 있다는 것도 색다른 경험이었다.
이런저런 이야기를 나눌 수 있어 반가운 시간이었다.
이번 VLDB는 처음으로 accept된 학회 논문을 직접 발표했다는 점에서 기억에 오래 남을 것 같다. Aker 연구를 함께 진행해 주신 공동저자분들과 연구 및 학회 참석을 지원해주신 교수님께 감사드린다. 보스턴에서 찍은 사진 몇 장을 남기며 후기를 마친다.
 |
 |
 |